一个代码助手修复了今天的错误,明天处理另一个项目时,仍可能重复同一种错误。要让经验持续发挥作用,系统需要把有效做法保存下来,在后续任务中使用,并根据结果继续修订。进一步,系统还可以改进自己寻找问题、选择实验和验证修改的方法。
这就是递归自我改进(Recursive Self-Improvement,RSI)研究的问题:一次工作既产生任务结果,也留下能帮助后续学习的系统变化。
本文解读 Yi Duan 等人于 2026 年 9 月 10 日提交的 《The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement》v1。这是一篇 75 页的综述与路线图,包含能力统计、方法分类和初步产业案例。标题表达的是研究愿景;正文提供的证据主要支持特定范围内的持续适应和改进机制。阅读时可以围绕一个问题展开:这一轮究竟改变了什么,下一轮如何受益?
从一次修正到持续学习
先区分三个常用概念。大模型根据输入生成内容;智能体(Agent)在模型之外加入工具和执行流程,可以读取文件、运行代码、检查结果;系统的持久状态则是任务结束后仍然保留、能够影响后续工作的部分。
大模型的参数是持久状态的一种,提示词、经验库、可复用工具和智能体的执行程序也可以承担这一作用。论文用 harness 指模型外围组织上下文、工具调用和执行控制的程序,本文称为“执行框架”。原文 §2.2
假设代码助手遇到日期处理错误,三个动作会产生不同的后续效果。下面是用于解释概念的示例。
| 动作 | 保存的结果 | 后续任务如何受益 |
|---|---|---|
| 根据报错修复当前函数 | 业务项目中的补丁 | 当前项目恢复正常;助手处理新任务的方式可能保持原样 |
| 提炼并验证日期检查规则 | 助手的可复用技能,例如检查时区和夏令时边界 | 后续日期任务会使用这条规则 |
| 改进技能生成与验证流程 | 助手用于总结经验、筛选规则的程序 | 以后生成的其他技能也有机会更可靠 |
这里需要先明确“系统”包含哪些组件。如果研究对象是代码助手,那么业务代码与助手自身的工具、技能和执行框架属于不同的修改对象。评估自我改进时,要追踪变化是否返回被研究的系统。
第二行已经体现持续学习。第三行进一步把“如何学习”变成可修改的对象,呈现出递归结构:改进后的方法参与产生下一轮改进。
一轮自我改进如何运行
论文把完整的改进循环作为分析单位。下图用代码助手说明基本流程;橙色区域表示进一步修改改进方法的路径,是依据论文 §2.2 与 §3.6 重绘的教学示意。
本文图表均可点击打开矢量原图,放大查看。
第一步:从任务中收集可检查的证据
助手记录工具调用、测试结果、实际修改和人工纠正,以便确定失败发生在哪一步。例如,日期计算错误可能来自模型推理,也可能来自工具返回了未标明时区的时间。
“答案错了”只给出结果;输入、执行记录和预期行为共同构成可以用于诊断的经验。
第二步:提出具体的修改假设
负责改进的组件根据证据提出候选修改。例如:“为日期工具增加时区字段,可能减少跨地区任务的日期偏移。”候选修改应同时说明预期效果和适用条件,便于后续验证。
修改可以发生在模型参数之外。补全工具说明、改变文件检索顺序,或者加入一个可复用检查脚本,都可能改善整个系统的行为。
第三步:验证收益和已有能力
验证组件检查候选修改是否有效,以及原本能够完成的任务是否受到影响。工程上可以让旧版本和候选版本处理相同的测试任务,再用独立任务检查效果能否推广。
这里的“独立任务”指没有参与生成和筛选这次修改的任务。如果系统反复依据某组题目调整自己,这组题目就承担了开发反馈的作用,需要另外保留衡量泛化能力的测试。
第四步:保存版本并观察后续使用
通过验证的修改连同证据、适用范围和版本信息一起保留。后续任务使用新版本,再产生新的反馈。保存的经验还需要在适当时机被读取并正确执行,才能转化为实际收益。
论文把提出修改的机制称为 improver,把判断能否接受修改的机制称为 verifier。最值得追踪的正是这两个组件:它们如何变化,以及变化是否真正影响了后续轮次。原文 §2.2.1、§3.5
五个层级分别把哪些决策交给 AI
论文按照 AI 承担的改进责任,提出 L1 至 L5 五个层级,并用 B0 表示仅在当前任务内修正输出的参考情形。下面沿用日期处理的示例,把层级对应到具体行为;示例用于教学,不是论文中的实验配置。
| 层级 | AI 承担的决策或操作 | 代码助手示例 |
|---|---|---|
| B0 当前任务内修正 | 修订本次输出 | 根据失败测试反复修补当前函数,任务结束后没有保留助手自身的变化 |
| L1 执行改进 | 执行人类规定的更新流程 | 按既定规则提取日期处理经验,通过规定的检查后写入技能库 |
| L2 选择改进策略 | 判断下一步应修改哪里、如何修改 | 根据失败记录,选择改工具接口、上下文组织方式或技能内容 |
| L3 选择学习经验 | 根据当前弱点决定接下来练什么 | 发现夏令时问题后生成或选取针对性任务;学会后调整下一批练习 |
| L4 从部署交互中适应 | 决定实际使用经验如何改变后续行为 | 持续处理不同项目,依据结果更新规则,并停用已不适用的经验 |
| L5 改进改进机制 | 修改并复用产生、验证或选择后继版本的方法 | 发现“一次成功就保存规则”不可靠,改进技能筛选程序,并用于下一轮技能更新 |
L1 与 L2 的差别是“按规定执行”到“选择值得尝试的修改”。L2 与 L3 的差别是从给定经验中寻找改法,到根据自身能力主动安排未来经验。L4 强调持续使用中的环境变化和经验复用。L5 则要求产生未来改进的方法本身成为可继承的状态。原文 §3
学习经验可以来自已有数据
L3 的关键在于学习安排会随系统能力改变。例如,助手从已有题库中先选择时区转换题,再根据学习后的错误分布转向并发问题,也能形成这类反馈关系。自动生成大量题目只是经验获取的一种实现方式。
论文以 VOYAGER 为例:它在 Minecraft 中依据当前状态和探索历史安排目标,把成功行为保存成可执行技能。新增技能又会影响之后能够尝试的目标。原文 §3.4
层级描述责任范围
这些层级适合分析一条具体的改进循环。一个系统可能在选取练习任务上表现出 L3 特征,却在上线更新时依赖固定流程和人工审核。论文也用“候选”“局部机制”等限定描述部分系统。
基础模型的能力、自动化程度、修改权限和实际收益需要分别测量。即使到了 L5,人类仍可以规定总体目标、资源预算、受保护的评估和部署权限。较高层级描述更广的改进责任,收益则需要实验验证。原文 §3.6—§3.7
HCI 如何比较不同能力的进展
作者先统计大模型在不同领域的能力变化,以说明哪些任务仍有较大的改进空间。统计覆盖 2023 年至 2026 年 9 月,包含十个能力领域的 393 条符合纳入条件的模型—基准观测。原文 §2.1
不同测试的起点不同。某项测试从 80 分升到 90 分,另一项从 20 分升到 30 分,虽然都增加了 10 分,但前者填补了原先剩余差距的一半,后者只填补了八分之一。
HCI 的全称是 Headroom-Closed Index,可以理解为“已弥合的剩余差距比例”。论文的归一化公式可以写成:
1 | HCI = 100 ×(当前得分 − 起点得分)÷(100 − 起点得分) |
其中,起点采用该基准进入数据集首年的模型得分第 90 百分位,用来代表当年的前沿水平。当前得分会先合并可比较来源;HCI 为 0 对应起点,为 100 对应该测试的满分。
用一组假设数值演示:起点 40 分,当前 70 分,则原来还有 60 分差距,现在填补了 30 分,因此 HCI 为 50。这个 50 表示填补了一半原有差距,当前测试得分仍然是 70。
2026 年的统计呈现明显差异
下图依据论文 §2.1 重绘十个领域的 2026 年 HCI。所有横条都使用 0—100 的同一坐标;其中网络安全的数据存在评估协议变化,需要单独看待。
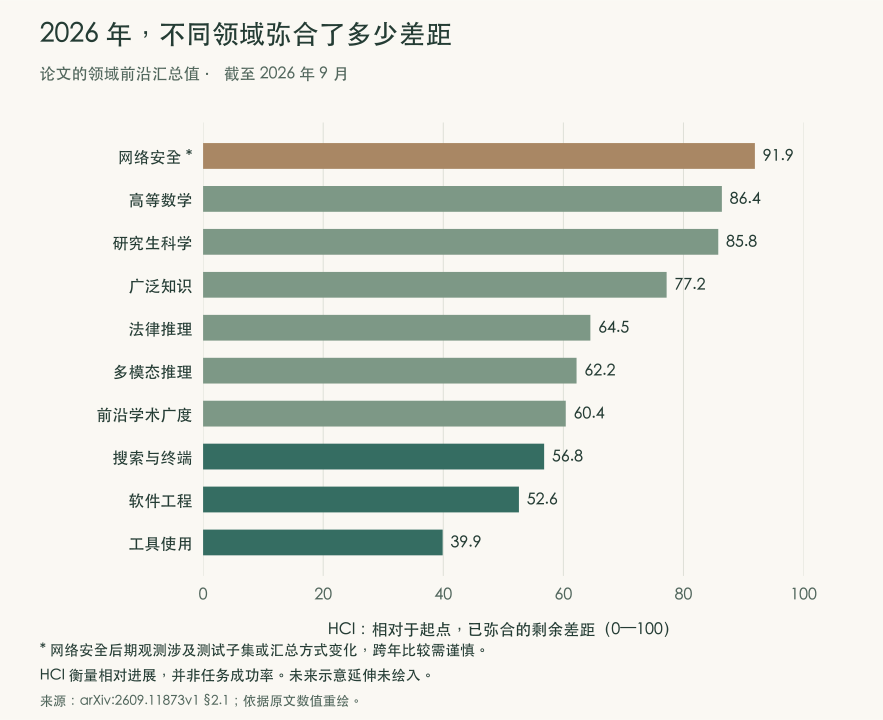
领域数值还经过一层汇总:作者先计算每个基准每年的第 90 百分位 HCI,再按参评模型数量的平方根加权。这样,覆盖模型较多的基准具有更高权重,同时限制大型榜单对总值的支配程度。
数学和科学问答弥合的差距较多,软件工程和工具使用仍保留较大空间。后两者涉及多个相互依赖的动作:选工具、检查状态、解释返回值、调整计划。一次错误还会改变之后面对的环境,这使整段交互的反馈尤其有价值。
这些统计可以说明能力进展的不均衡。解释时还要保留三个条件:HCI 依赖基准起点和题目覆盖;它是领域前沿的汇总,不能直接用作某个模型的任务成功率;网络安全后期观测涉及 Cybench 子集或 pass@1 汇总变化,论文为此使用了虚线。
图中的未来延伸是作者设定的情景
论文原图 3 还画出了 2026 年之后的延伸区域。作者使用下面的公式构造终点:
1 | 示意终点 = 100 − 0.22 ×(100 − 2026 年 HCI) |
这相当于假设再弥合剩余差距的 78%。工具使用因此从 39.9 延伸到约 86.8,软件工程从 52.6 延伸到约 89.6。
这些终点来自同一设定,用于表达“剩余空间越大,潜在收益越大”的设想。把它们用于判断未来进步速度、实现时间或 RSI 的实测效果,会超出这组数据的证据范围。本文的横条图只绘制 2026 年统计值。原文图 3 与公式 4
初步实验已经支持哪些结论
这篇综述引用了研究论文、技术报告和企业内部实践。以下选择三个有助于理解机制的案例,并保留原文的证据范围;文中数值是论文报告结果,本文未重新运行这些实验。
工作环境整理可以改变同一模型的表现
Theseus 的生产力工作区实验保持模型与执行框架配对不变,对比原始工作区和经过整理的工作区。整理后的环境提供一套共享的 Collection Map 与 Event Log,可以分别理解为资料集合的索引和事件记录。评测包含 30 个任务、547 条评分细则。
下图完整重绘论文表 9b 的五组得分。连线两端分别代表原始环境和整理后的环境,横轴表示评分细则得分。
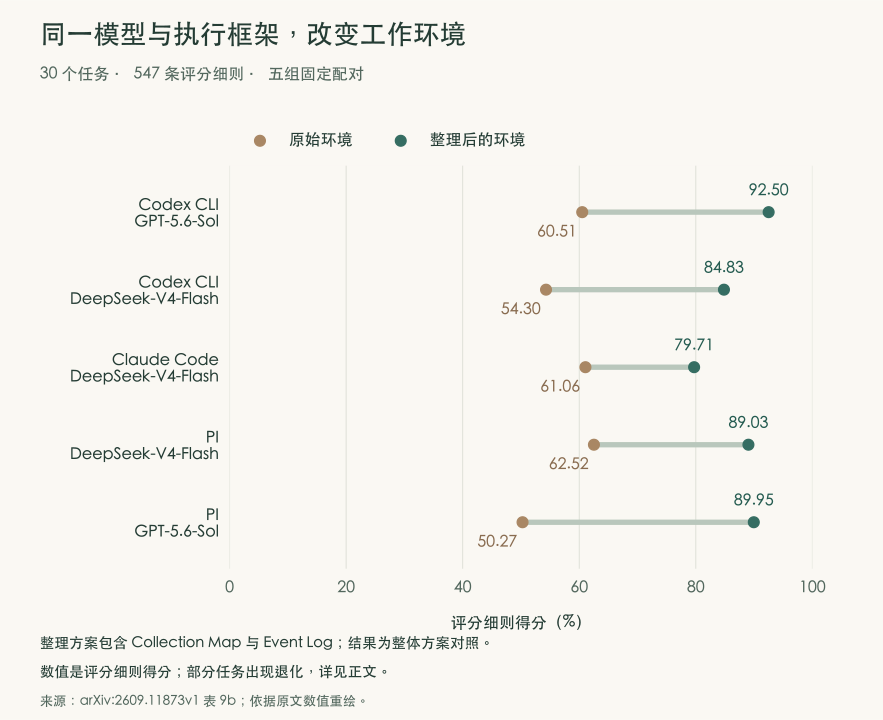
五组配置的报告增益为 18.65—39.67 个百分点。以第一组为例,92.50% 表示汇总评分细则的得分;任务层面的结果是 24 项改善、3 项持平、3 项下降。原文还报告了部分任务出现超出需求范围的额外修改。原文 §5.1、表 9b
这个实验支持一个具体判断:整理信息环境,是改善智能体任务表现的有效候选方向。由于对比对象是一整套环境整理方案,单凭该实验还无法分离索引与事件记录各自的贡献,也无法验证多轮模型训练与环境改进是否会持续累积收益。
质量检查系统可以从误判中更新规则
Humanlaya 的案例更接近日常工程。系统处理任务说明、附件、参考答案和评分标准组成的数据包。一次检查中,解析工具未能提取一份三页扫描 PDF 的内容,系统据此判定附件不可用。人工复查发现扫描内容清楚,问题出在提取过程。
这次反馈促使系统提出新的判断规则和示例,把“提取失败”与“文档质量不足”分开检查。规则经过独立数据包验证和人工审核后,成为后续批次使用的新版本。
原文报告,在保持基础模型、工具和处理预算相同的条件下,V0 与经过四次反馈更新的 V4 在 600 个未参与更新的数据包上有以下差异:
| 指标 | V0 | V4 | 变化 |
|---|---|---|---|
| 自动修复后仍有关键缺陷的数据包比例 | 9.0% | 3.7% | 下降 5.3 个百分点 |
| 每项任务平均人工处理时间 | 48 分钟 | 27 分钟 | 减少 21 分钟 |
这里保存的是质量检查系统的规则、提示词、示例和技能。收益来自后续批次复用经过验证的变化。结果属于企业内部对照,说明这种流程具有可行性;数据分布、长期效果和独立复现仍影响结论的适用范围。原文 §5.3
改进研究策略已经有局部证据
A-Evolve-Training 把多轮训练实验产生的配方变化、评估结果和失败记录汇总起来,再由负责研究安排的智能体修改下一轮搜索策略。
其中一个触发条件是:开发集分数提高,外部评测没有同步提高。系统据此调整研究方向,把更多注意力转向数据重新配比和训练检查点选择,并保留不再值得重复的尝试记录。论文引用的实验在一个 30B 模型上运行四轮,外部得分从 0.80 升至 0.86;其引用的人类最佳提交为 0.87。原文 §1.2、§3.6.3
这个案例的递归特征在于:下一轮继承了经过修改的研究策略。总体研究目标、工作组件和约束仍由外部设定。当前成绩能够支持策略层面的局部改进,关于跨任务、跨世代的稳定收益,还需要进一步验证。
如何证明改进方法本身有效
论文区分了两种强度不同的证据。
结构上的递归:系统修改了改进方法,保存了新版本,并在下一轮实际调用。通过版本记录和执行日志,可以证明这条调用关系存在。
有效的递归:在相近起点、相同总预算和独立评估下,新方法能够产生更好的后续版本。它要求回答一个更难的问题:收益有多少来自方法改进,而有多少来自多运行了实验、使用了更强模型或更宽松的评估?
下面是用于验证这一点的对照设计建议,依据论文 §3.6.5 整理。
| 对照组 | 起点与输入 | 允许变化的部分 | 比较结果 |
|---|---|---|---|
| 原改进方法 | 相同初始助手和可用证据 | 按原方法产生候选版本 | 独立任务成绩、成本、退化情况 |
| 新改进方法 | 相同初始助手和可用证据 | 按新方法产生候选版本 | 独立任务成绩、成本、退化情况 |
总预算需要包含候选生成、任务执行、验证,以及开发和评估改进方法本身的成本。由于实验存在随机性,还应比较多次运行的完整过程,包括失败更新、能力下降和恢复时间。
这个区分能解释论文中的一个关键限制:Weco 报告 AIDE2 在 100 步无人值守搜索中接受了七次改进,但把演化后的执行框架安装为外层改进者后,进一步实验没有建立统计显著的搜索效率优势。因此,“产生了更强版本”与“以后能更高效地产生强版本”需要各自的证据。原文 §3.6.4—§3.6.5
为什么不同领域的进展不同
自我改进需要反复获得反馈、提出修改和验证收益。反馈的速度、可靠程度和代价会直接影响循环能够运行多少次。
| 场景 | 常见反馈 | 对改进流程的主要约束 |
|---|---|---|
| 软件工程 | 单元测试、运行结果、性能测量、代码审查 | 测试覆盖和需求表达决定验证范围,还要检查跨仓库、跨版本效果 |
| 科学研究 | 模拟结果、实验测量、理论检验 | 实验可能昂贵且反馈延迟;失败原因涉及假设、协议和仪器 |
| 具身智能 | 机器人或仿真环境中的动作结果 | 感知、规划和控制共同影响结果,真实环境的试验与复位存在成本 |
| 医疗研究与应用 | 历史病例、专家纠正、长期结果 | 结果归因、患者群体差异和机构条件限制经验迁移,更新需要专业验证 |
软件中的程序和工具可以直接修改、执行和重复测量,因此容易形成短周期实验。物理试验与临床反馈则要求更严格地控制候选更新、记录适用条件,并在真实使用前完成相应验证。论文对医疗的许多案例仍基于模拟或回顾性数据。原文 §4
把论文转化为工程设计
对于已有大模型应用的团队,可以先建立一条可测量的经验更新流程。下面是本文根据论文整理的实施建议,不是作者提供的统一实现规范。
第一,选择一种反复出现且结果可检查的失败,例如工具参数错误或遗漏必要文件。记录输入、工具版本、执行轨迹和正确结果,使每个候选修改都有可追溯的依据。
第二,选择一个可单独替换的改进对象,例如一段工具说明或一份技能文档。明确它在什么条件下会被加载,以及预期改变哪个动作,便于定位收益来源。
第三,区分用于生成修改的案例、用于筛选候选的开发任务和最终独立测试。记录旧版与新版各自修复了多少任务、破坏了多少原有能力,以及模型调用、执行和人工复核的成本。
第四,为经验增加适用范围和版本管理。随着工具、模型或任务变化,定期检查已有经验是否仍被使用、是否仍有效,保留恢复到已验证版本的能力。
第五,在上述流程稳定后,再允许系统试验改进方法,例如失败归类规则或技能筛选策略。评价重点随之增加一项:相同预算下,新方法是否让后续更新更可靠、更有效。
这篇论文最有工程价值的贡献,是把“AI 会越来越强”拆成可以检查的关系:任务留下什么证据,证据触发什么变化,变化如何被验证和保留,以及它是否改善了下一轮学习。沿着这些关系建立记录和对照,才能判断一个系统在哪个环节取得了进展,下一步的投入又应放在哪里。
原文与图表说明
- 论文摘要与固定版本 v1:2026 年 9 月 10 日提交。
- HTML 全文与 PDF 全文:定义与 HCI 见 §2,层级与评价方法见 §3,应用见 §4,产业实践见 §5。
- 本文流程图为教学重绘;数值图依据原文 §2.1 和表 9b 绘制。表 9b 的 PI/GPT-5.6-Sol 一行,两个显示值相减为 39.68,而原文增益列为 39.67;正文范围保留原文报告值,图中直接使用两个得分。
- 为适应基础机器学习背景,本文选取与改进循环直接相关的案例,省略逐项方法目录、企业名录和细分训练技术;完整分类见原文及附录。层级归属采用作者的分析框架,实验结论保留其来源和适用范围。